GPT-6 Astra: o que muda para quem faz marketing
Explore composição, imagem e movimento em exemplos que você pode ajustar. Use as decisões visuais para orientar a próxima peça da sua marca.
 Galeria · luz, escala e espaço para o texto.
Estúdio Aurora: projeto fictício. Imagens geradas por IA para os exercícios.
A OpenAI lançou em 3 de setembro de 2026 um modelo que opera o computador como uma pessoa: abre o navegador, preenche formulário, mexe em planilha, monta apresentação no seu modelo e confere o resultado na tela. Para uma operação de marketing, o ganho aproveitável está na primeira tentativa, que agora sai perto do apresentável. O preço por token subiu duas vezes e meia. Esta página mostra onde vale, onde não vale e como pedir.
Quanto custa e como usar: na API Standard, a tabela de 5 de outubro de 2026 publica US$ 10 por milhão de tokens de entrada e US$ 50 de saída. Acima de 272 mil tokens de entrada, a requisição usa US$ 20 e US$ 75, respectivamente. Esses valores não são mensalidade de ChatGPT ou Codex. No marketing, teste o modelo em entregas reais e compare qualidade, custo e tempo antes de adotá-lo.
Exemplo prático: uma agência que prepara a página de captura de uma campanha anexa o manual da marca e duas referências reais, define como pronto a página abrindo bem no celular com o formulário funcionando e recebe o rascunho montado dentro do programa. A equipe revisa um resultado concreto, em vez de copiar texto e colar peça por peça.
Cena: quinta-feira, 3 de setembro de 2026, sete e quarenta e nove da noite. A OpenAI publica um vídeo de trinta segundos com uma frase curta: qualquer coisa que você faça num computador, o Astra faz por você. Em nove horas o post tinha 36 milhões de visualizações. Ao fim da semana, 125 milhões.
Minutos depois do anúncio, o presidente-executivo da empresa avisou que o próprio post do blog tinha travado no deploy. No dia seguinte ele pediu desculpas pelo lançamento bagunçado. No dia 5 a liberação terminou adiantada e todo mundo com plano pago ganhou um crédito de compensação. A semana inteira do produto coube em 48 horas.
Aqui está o que sobra depois do barulho: o que o modelo faz de diferente, quanto custa de verdade, onde ele erra e o que a sua operação deveria testar nos próximos trinta dias.
- 47% menos tempo por tarefa de área de trabalho que o modelo anterior OSWorld 2.0, OpenAI, 03/09/2026
- US$ 4,72 por tarefa de código, contra US$ 9,18 do concorrente de mesmo preço por token Artificial Analysis, 03/09/2026
- 2,5x o preço por token do antecessor: US$ 10 de entrada e US$ 50 de saída Página oficial do modelo
- 272 mil tokens de entrada: acima disso, entrada 2× e saída 1,5× Medição publicada em 06/09/2026
- Uso de computador
- Custo por tarefa
- Design e layout
- Governança
- Piloto de 30 dias
O que mudou de fato
O GPT-6 Astra opera o programa em vez de devolver texto para você colar. Ele abre o software, executa, confere o resultado na tela e corrige antes de entregar. A conferência visual saiu da sua mesa e entrou na execução. No teste OSWorld 2.0 ele acerta 72,6% das tarefas de área de trabalho, em cerca de 40 minutos por tarefa contra 75 do antecessor.
Modelos anteriores devolviam texto e código. Você lia, copiava, colava e testava. O Astra devolve o trabalho pronto dentro do programa em que o trabalho vive. Ele enxerga a tela, clica, digita, confere o que apareceu e corrige o que quebrou.
A lista oficial de tarefas do dia a dia é banal de propósito: preencher formulário na internet, atualizar cadastro de cliente no CRM, organizar agenda, pesquisar e escrever o resumo dentro do seu editor de texto, analisar dados, gerar gráfico, criar um site e conferir se os botões funcionam.
Ver o diagrama do ciclo completo
Duas medições dão a dimensão. Numa bateria de tarefas de área de trabalho, o modelo acertou 72,6% contra 65,7% do antecessor, gastando cerca de 40 minutos por tarefa em vez de 75. Em localizar o elemento certo numa captura de tela de programa profissional, foi de 76,9% para 92,7%.
47% menos tempo por tarefa. O ganho de acurácia é de sete pontos. O ganho de tempo é quase metade. Para automação, o segundo número decide se o fluxo fecha a conta.
Percorra uma tarefa visual
O mesmo briefing acompanha toda a execução. Selecione uma etapa para ver o que deve entrar e o que precisa sair dela.
Reúna a identidade da marca, a imagem principal e a ação que a pessoa deve conseguir realizar. O exemplo acompanha a página fictícia do Estúdio Aurora.
O salto que interessa: a primeira tentativa
O ganho aproveitável do GPT-6 Astra está no primeiro rascunho, e não no teto de qualidade. Um avaliador que levava cerca de quinze rodadas com o modelo concorrente obteve clima de marca equivalente no passe inicial do Astra. A assinatura estética é a separação da página em quatro planos de profundidade que correm em velocidades diferentes na rolagem.
Quem produz peça visual em volume conhece o custo escondido: o rascunho inicial sai genérico e você gasta a tarde inteira puxando ele para o tom da marca. Foi exatamente aí que a régua se moveu.
Um criador que vinha construindo um site com o modelo concorrente ao longo de cerca de quinze rodadas constatou que o primeiro passe do Astra num site equivalente já batia o clima e a aderência de marca da versão muito trabalhada. O resultado final iterado do concorrente continuou melhor. O que encolheu foi a distância até o primeiro rascunho apresentável.
A leitura correta: este modelo tem o melhor piso de qualidade visual, e o teto continua disputado. Se a sua dor é chegar rápido ao primeiro rascunho decente, o ganho aparece imediatamente. Se a sua dor é o acabamento das últimas rodadas, o ganho é menor.
A diferença estética mais citada tem nome técnico e efeito simples: camadas de profundidade. Em vez de uma imagem chapada atrás do texto, os elementos ficam em planos separados que se movem em velocidades diferentes conforme a pessoa rola a página. Fundo, meio-campo, objeto em primeiro plano, texto por cima.
Ver o esquema estático dos quatro planos
O mesmo conteúdo, outra hierarquia
Troque o formato e a tipografia. O título mantém a prioridade; a imagem se reorganiza para caber no espaço disponível. Esta composição é um exercício, sem pontuação de qualidade entre modelos.
para o espaço.Encontros entre matéria, luz e paisagem.Explorar a exposição
Separe os planos para dirigir o olhar
Afaste os quatro planos do exemplo. A separação mostra como fundo, ambiente, objeto e texto podem receber movimentos distintos mantendo a leitura em primeiro plano.
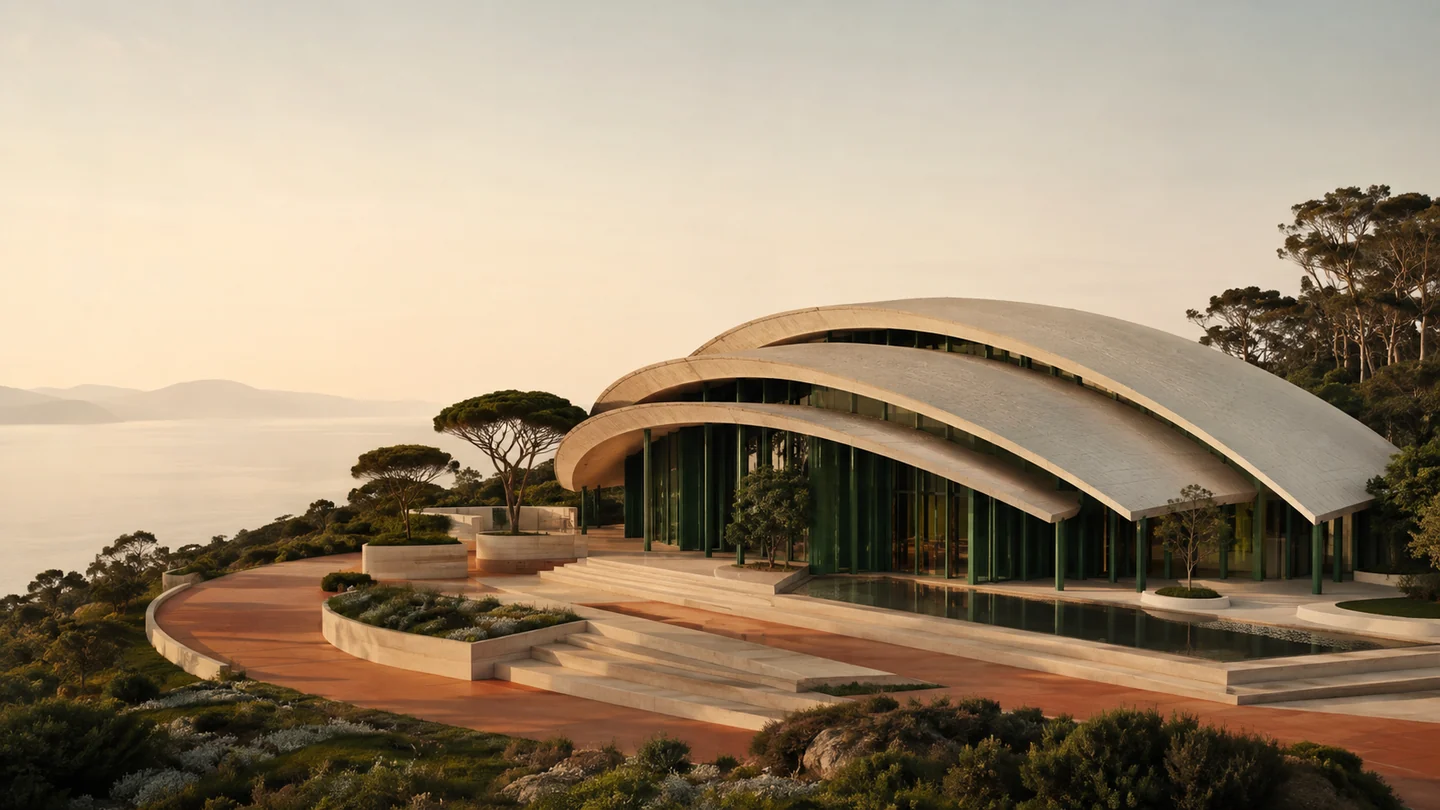
para descobrir.ESTÚDIO AURORA
- 01Fundo: estabelece o lugar.
- 02Ambiente: cria distância.
- 03Objeto: concentra a atenção.
- 04Texto: preserva a mensagem.
Compare o tratamento da mesma imagem
Arraste a divisão para conferir cor e contraste. A simulação usa filtros sobre a mesma imagem: o sujeito e o enquadramento permanecem iguais, enquanto o tratamento muda.
Ao pedir variações, nomeie o que deve continuar: material, luz, paleta e proporção do objeto. Depois escolha o recorte para cada canal.
Dê ao movimento um começo e uma chegada
Compare velocidade constante com uma chegada suave. Percorra quadro a quadro para observar a posição do objeto; depois reproduza a passagem completa.
O trabalho visual foi longe do site. Na semana do lançamento apareceram uma locomotiva a vapor reconstruída a partir de um desenho antigo com 3.295 objetos editáveis, um site que desmonta a anatomia humana em 2.234 peças, uma casa modelada e transformada em passeio navegável, e uma montagem de vídeo: mais de 150 gigabytes de material bruto de um evento viraram um minuto de resumo sincronizado com a música em cerca de 35 minutos.
Modelo e ferramenta têm capacidades diferentes. A ficha do Astra lista entrada de texto e imagem e saída de texto; áudio e vídeo não são modalidades nativas. Operar um editor ou acionar geração de imagem exige ferramentas integradas. A data oficial de encerramento do Sora 2 e da Videos API, 24 de setembro de 2026, já passou; o aviso não oferece um substituto direto.
Progresso em inteligência não garante progresso em alinhamento. Não aceitaremos degradação da nossa capacidade de monitorar o alinhamento do modelo além de certo nível.
Da composição à montagem
Estas animações didáticas mostram decisões de layout, recorte e sequência. Cada vídeo começa quando você aperta o play e pode ser acompanhado pelas legendas ou pela descrição.
Ler a descrição da sequência
O título assume a maior escala. Linhas de alinhamento organizam a abertura e criam espaço para o conteúdo respirar. A área visual entra ao lado do título. O enquadramento preserva uma zona tranquila para a leitura. Agenda e chamada para ação completam a página. A hierarquia conecta o interesse inicial ao próximo passo do visitante.
Ler a descrição da sequência
A direção de arte começa com sujeito, luz e materiais. O estudo gráfico usa uma peça cerâmica como exemplo de composição. O retângulo de enquadramento se ajusta ao sujeito. A área livre permite inserir título e adaptar a imagem a diferentes formatos. Três composições preservam o mesmo sujeito e a mesma paleta. Variam o recorte e a posição, mantendo uma família visual reconhecível.
Ler a descrição da sequência
Três tomadas ilustrativas entram na seleção: abertura, detalhe e encerramento. Cada uma ocupa um papel no roteiro. Os trechos selecionados se encaixam na linha do tempo. O cursor de reprodução atravessa os cortes e mostra a sequência. A montagem termina em uma tela com marca e chamada para ação. Revise texto e duração antes de exportar o arquivo final.
Quanto custa de verdade
Na API Standard de outubro de 2026, o GPT-6 Astra custa US$ 10 por milhão de tokens de entrada e US$ 50 de saída na faixa curta. A medição histórica citada encontrou uma tarefa de código a US$ 4,72 contra US$ 9,18 do concorrente. Esse resultado depende da tarefa e da configuração; não garante que toda entrega custará menos.
As comparações de setembro de 2026 registram economia em algumas tarefas e configurações, apesar da tarifa maior que a do modelo usado como referência. O consumo de tokens varia com a tarefa, o contexto, o esforço e as tentativas. A escolha atual deve comparar o custo total para alcançar o mesmo critério de aceite.
A unidade certa é a tarefa concluída. Comparar preço por milhão de tokens entre os dois modelos de fronteira é inútil, porque o número é idêntico. O que separa é quantos tokens cada um queima para terminar o mesmo trabalho. Numa medição independente, uma tarefa de código saiu por cerca de US$ 4,72 no Astra contra cerca de US$ 9,18 no concorrente.
A faixa de contexto longo é uma regra publicada de preço por requisição. Acima de 272 mil tokens de entrada, o Astra usa o dobro da tarifa de entrada e uma vez e meia a de saída em toda aquela requisição. A regra não recalcula requisições anteriores. Na tabela Standard de outubro de 2026, isso significa US$ 20 na entrada e US$ 75 na saída por milhão de tokens.
O padrão econômico que a comunidade convergiu
Vários operadores independentes chegaram à mesma receita na mesma semana: o modelo caro planeja e revisa, e um modelo barato executa. Guardar o esforço alto para o passo que decide, e usar esforço baixo na varredura. Quem manteve o modelo caro como orquestrador em tarefa longa relatou queimar 80% da cota de cinco horas numa única tarefa.
Três alternativas para testar no seu fluxo: reutilizar o prefixo do prompt quando houver cache elegível; usar lote quando o prazo permitir; e comparar níveis de esforço com o mesmo critério de qualidade. Na API Standard de outubro de 2026, o cache lido na faixa curta custa US$ 1 por milhão e a escrita custa US$ 12,50. Esse desconto na leitura não equivale à mesma redução na fatura inteira, e não há ordem universal de economia entre as três alternativas.
O GPT-6 Astra representa uma mudança em degrau na capacidade do modelo para problemas de raciocínio interativo. Ele pontua 66% no ARC-AGI-3 usando o nosso arnês padrão, e quase 100% com um arnês de conversa contínua, a um custo de cerca de 360 dólares por partida.
Onde ele erra
O GPT-6 Astra falha de três formas medidas por avaliadores independentes. Ele completa o que não viu e inventa detalhe ausente da referência. Repete o mesmo gosto visual em projetos sem relação quando ninguém dirige a arte. E carrega a tela de rótulos redundantes justamente no esforço máximo, onde se esperava mais clareza.
Três defeitos apareceram de forma consistente em testes independentes, e todos os três têm conserto.
Ele completa o que não viu
Um testador pediu a reconstrução tridimensional de uma casa a partir das fotos de um anúncio imobiliário. O resultado impressionou e continha detalhes que a casa real não tem. Outro, reconstruindo uma peça a partir de desenho técnico, registrou que era preciso conferir proporção.
A regra é curta: onde a peça representa algo real, alguém confere contra a fonte antes de publicar. O modelo preenche lacuna com o que é plausível, e plausível às vezes é falso.
O gosto padrão se repete
Sem direção de arte, ele puxa para verde-floresta, tons pastel e superfícies chapadas. Dois avaliadores registraram o mesmo padrão em cinco ou seis projetos sem nenhuma relação entre si. O conserto custa uma frase: nomeie a paleta e a direção visual no pedido.
Esforço alto às vezes piora a interface
Num teste de tela de acesso, o modelo empilhou rótulos redundantes numa página que pedia simplicidade. O detalhe contraintuitivo: piorava com o esforço no máximo. Mais raciocínio produziu mais elementos, e a clareza caiu. Para página simples, comece no esforço baixo ou médio.
Como pedir
O GPT-6 Astra pergunta mais e assume menos que o antecessor, o que o torna melhor colaborador e pior executor solitário. Três instruções resolvem: viés para a ação tratando pedidos como ordens de executar, definição explícita do que significa pronto, e aprovação pedida apenas sobre um resultado concreto já revisável.
A própria documentação da OpenAI registra que este modelo pergunta mais e assume menos que o anterior. Isso o torna melhor colaborador e pior executor solitário: ele para onde você esperava que continuasse. O texto abaixo resolve o problema.
Infira a intenção e o escopo pelo contexto. Trate pedidos como ordens de executar. Trabalhe de forma independente até o objetivo ser alcançado, salvo ação destrutiva ou irreversível. Peça aprovação apenas sobre um resultado concreto e revisável.
Use parágrafos claros, cada um com uma ideia. Use lista apenas quando os itens forem realmente paralelos. Palavras familiares, exemplos concretos, voz ativa. Ponto principal cedo. Evite fechos de resumo e expressões de encheção.
Uma composição no primeiro quadro da tela. O nome da marca em tamanho de destaque. Imagem de borda a borda, sem selo ou etiqueta flutuando por cima. Duas famílias de fonte, uma cor de destaque. Dois ou três movimentos com propósito. A página precisa carregar bem no celular.
O que muda mais o resultado do que qualquer prompt: alimentar referências reais. Componentes e páginas de bibliotecas de design e de premiações públicas, anexados ao pedido, fizeram mais diferença nos testes do que qualquer ajuste de texto. Pedir apenas "faça um site" produz página genérica em qualquer modelo.
Arquivos de contexto mais curtos
Quem trabalha na ferramenta de desenvolvimento da própria OpenAI publicou o conselho mais contraintuitivo da semana: os arquivos de instrução que você escreveu para ajudar o modelo antigo agora atrapalham o novo. Receita rígida passo a passo prende o modelo. Lembrete de "seja cuidadoso, teste tudo de novo" gera trabalho redundante, porque ele já testa. O que ajuda é definir o que significa "pronto" e onde ele pode agir sem pedir permissão.
Monte um pedido com direção visual
Escolha a entrega, a direção de arte e o público. O pedido combina essas decisões com critérios de pronto; substitua o Estúdio Aurora pela sua marca e anexe as referências.
O que evitar
Com o GPT-6 Astra, evite publicar peça que representa algo real sem conferência humana contra a fonte, dar acesso à sua conta pessoal, deixar o agente rodar sem condição de parada e trocar o modelo padrão sem medir. Os resultados históricos de atendimento citados nesta página são motivo para testar esse uso; não definem a qualidade de toda operação atual.
A imagem gerada representa o que existe de verdade?
Compare a peça gerada com a referência antes de apresentar um produto, espaço ou equipamento real. Uma imagem convincente pode completar partes que a fonte não mostrou.
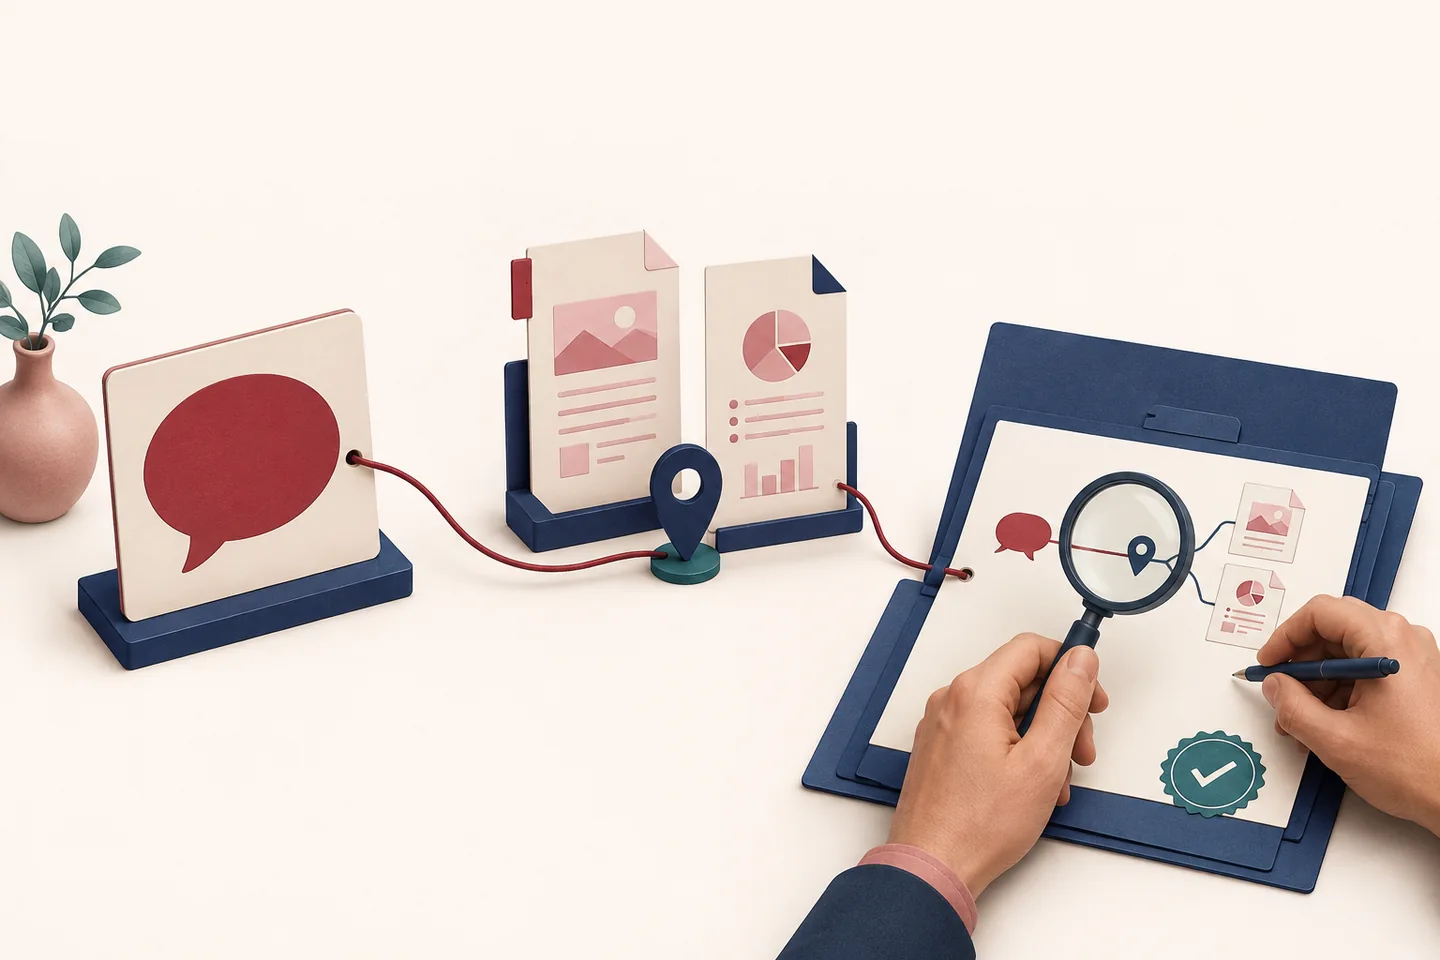
- O cartão apresenta a afirmação.
- O documento permite conferir seu alcance.
- A pessoa compara a afirmação com a prova.
Caso ilustrativoReferência preservada
A pessoa responsável pelo produto comparou a peça com o material fornecido e confirmou as características que ela apresenta.
- Resposta ao critério
- Sim
- Por que este ramo?
- A publicação se apoia na comparação com o objeto real, além da aparência visual.
- Próxima ação
- Confira o arquivo final na tela prevista para seu uso.
Caso ilustrativoDetalhe completado
Uma imagem de um espaço real ganhou uma abertura que não aparece no material de referência e não foi confirmada pela equipe.
- Resposta ao critério
- Ainda não
- Por que este ramo?
- O detalhe acrescentado pode apresentar uma característica inexistente.
- Próxima ação
- Retire a alteração e refaça a conferência com quem conhece o espaço.
- Etapa umDefina a referênciaEm foco
Detalhe e entrega
Separe o material real e identifique as características que a peça precisa preservar.
Entrega: Referência e condições de fidelidade.
- Etapa doisCompare a saídaEm foco
Detalhe e entrega
Procure elementos acrescentados, omitidos ou alterados e confira a leitura na tela em que a peça será usada.
Entrega: Diferenças localizadas na representação.
- Etapa trêsEncaminhe a revisãoEm foco
Detalhe e entrega
Quem conhece o objeto real confere as correções antes de liberar o uso da imagem.
Entrega: Peça revisada contra a referência.
O que fazer neste ramo
Mantenha a versão revisada e confira o arquivo final no formato de publicação.
O que fazer neste ramo
Aponte a diferença no próximo pedido e compare novamente a saída com o material real.
Comparar etapas, entregas e caminhos em tabela
| Passo ou caminho | O que considerar | Entrega ou consequência |
|---|---|---|
| Etapa um: Defina a referência | Separe o material real e identifique as características que a peça precisa preservar. | Referência e condições de fidelidade. |
| Etapa dois: Compare a saída | Procure elementos acrescentados, omitidos ou alterados e confira a leitura na tela em que a peça será usada. | Diferenças localizadas na representação. |
| Etapa três: Encaminhe a revisão | Quem conhece o objeto real confere as correções antes de liberar o uso da imagem. | Peça revisada contra a referência. |
| Decisão | A representação preserva as características reais conferidas por uma pessoa responsável? | Compare os dois caminhos abaixo. |
| Sim | Prepare o uso da peça | Mantenha a versão revisada e confira o arquivo final no formato de publicação. |
| Ainda não | Corrija a representação | Aponte a diferença no próximo pedido e compare novamente a saída com o material real. |
- Publicar peça que representa algo real sem conferência. Imóvel, produto, equipamento, planta. Ele completa o que não viu.
- Dar acesso à sua conta pessoal. Um programa que dirige o computador merece conta separada, com permissão mínima, como qualquer prestador.
- Deixar rodar sem condição de parada. Defina limite de tempo e o que encerra a tarefa antes de começar.
- Trocar o modelo padrão sem medir. As medições de atendimento de setembro de 2026 valem para seus testes e configurações. Compare modelos atuais nas suas conversas antes de substituir o padrão.
- Contar com cota generosa. No plano intermediário, usuários relataram esgotar a cota em dez a vinte minutos de trabalho, com cinco horas de espera.
- Assumir que o resultado é acessível. Não existe medição pública de contraste, leitor de tela ou comportamento em tela pequena para páginas geradas por ele. Isso continua com você.
Interrupção por segurança faz parte da operação. Este é o primeiro modelo que a OpenAI classificou no nível crítico em cibersegurança, e a empresa avisa que o sistema de proteção vai ocasionalmente travar trabalho legítimo, inclusive trabalho sem relação com segurança. No ChatGPT você é convidado a revisar e seguir. Na interface de programação a tarefa simplesmente para. Escreva o caminho de recuperação antes de precisar dele.
Um piloto de trinta dias
Um piloto de trinta dias com o GPT-6 Astra cabe em quatro semanas: instrumentar três fluxos reais e congelar a linha de base, trocar só o modelo mantendo prompt e dados, adaptar os prompts e encurtar os arquivos de contexto, e quebrar de propósito testando cota, interrupção de segurança e acessibilidade.
Trocar de modelo sem linha de base transforma a decisão em anedota. Quatro semanas bastam para ter número.
O que registrar em toda execução: custo total, tempo de relógio, número de intervenções humanas e uma nota de qualidade dada por quem recebe o trabalho. A nota vem de pessoa, e o modelo não avalia o próprio resultado.
Critérios de reprovação, escritos antes de começar: custo por tarefa acima da linha de base sem ganho de qualidade; mais de uma interrupção de segurança por semana em trabalho legítimo sem recuperação automática; qualquer peça publicada representando algo real com detalhe inventado que passou pela revisão.
Confira o resultado visual antes de ampliar
Use os mesmos critérios em cada versão do piloto. Marque o que você conferiu na peça real e leve os ajustes restantes para o próximo pedido.
Onde vale e onde não vale
O GPT-6 Astra pode ser candidato para tarefas exigentes com ferramentas, como uso de computador e revisão de código. Compare-o com modelos de menor custo nas mesmas entregas, inclusive atendimento, antes de escolher o padrão. A ficha oficial não oferece geração nativa de vídeo.
| Carga de trabalho | Escolha | O número que decide |
|---|---|---|
| Uso de computador e automação de software antigo | GPT-6 Astra | 72,6% no OSWorld 2.0, em 40 min por tarefa contra 75 min |
| Primeiro rascunho de página e peça visual | GPT-6 Astra | Clima de marca no primeiro passe, contra cerca de 15 rodadas |
| Acabamento visual após muitas iterações | Claude Fable 5.1 | Preferência declarada por testadores independentes |
| Tarefa de código fechada | GPT-6 Astra | US$ 4,72 por tarefa contra US$ 9,18, ao mesmo preço por token |
| Atendimento ao cliente | Fique no GPT-5.6 Sol | Regressão medida, por 2,5x o preço por token |
| Chat geral e raciocínio comum | GPT-5.6 Sol | Empate no índice independente, a US$ 4 e US$ 20 |
| Volume alto e barato | Modelos de entrada | Uma ordem de grandeza mais baratos por token |
| Geração de vídeo do zero | Nenhum dos dois | Astra não gera vídeo nativo; encerramento da API Sora 2 em 24/09/2026 |
Vale a pena: primeiro rascunho de página e peça visual; automação de sistema antigo que não tem integração; conferência de qualidade de site em vários tamanhos de tela; montagem de vídeo a partir de material bruto; apresentação a partir do seu modelo institucional; planilha e análise de dados; revisão de código com foco em segurança.
Onde a escolha exige comparação: atendimento, conversa geral e volume alto. Os testes históricos desta página não substituem uma avaliação com as conversas reais da operação. O guia oficial de seleção de modelos orienta comparar qualidade, custo e latência na tarefa. Para vídeo nativo, a ficha do Astra não oferece essa modalidade.
Perguntas frequentes
Isso é inteligência artificial geral?
O presidente da OpenAI disse que seria razoável sentir que a era chegou. A fundação que mantém o teste em que o modelo tirou a nota mais alta declarou publicamente que a organização não faz essa afirmação. Uma medição independente ampla coloca o modelo empatado com o antecessor em inteligência geral. Para efeito de decisão de compra, a pergunta rende pouco.
Preciso trocar o modelo que já uso?
Compare o modelo atual e os candidatos no mesmo conjunto de tarefas, com critérios de qualidade, custo e tempo. Os benchmarks históricos desta página ajudam a formular hipóteses; não comprovam vantagem universal em atendimento ou design. Adote por tipo de tarefa quando os resultados justificarem a troca.
Quanto vou gastar por mês?
Na API, some tokens de entrada e saída nas respectivas faixas, cache e ferramentas, incluindo tentativas que precisaram ser refeitas. Meça primeiro um lote de tarefas representativas e divida o custo pelas entregas aceitas; depois projete o volume mensal. Os casos históricos de US$ 4,72 e US$ 360 desta página têm tarefas diferentes e não estimam uma mensalidade.
Ele pode operar meus sistemas sozinho?
Tecnicamente sim, e a recomendação é tratar isso como contratação de prestador: conta separada, permissão mínima, dados de teste antes de dados reais, limite de tempo, aprovação humana antes de qualquer ação irreversível e registro auditável. Na API, Zero Data Retention depende de elegibilidade e aprovação prévia da OpenAI e tem limites por recurso; não é uma configuração universal nem comprova, sozinha, adequação à LGPD.
O que mudou para quem trabalha com design?
O primeiro rascunho ficou bom o suficiente para servir de ponto de partida real, e a conferência visual passou a acontecer dentro da execução. O julgamento sobre o que serve à marca e ao público continua sendo trabalho humano. Uma interface cheia de movimento pode ser certa para uma marca jovem e completamente errada para um público idoso, e essa decisão nenhum modelo toma por você.
Quanto custa o GPT-6 Astra?
Na API Standard, a tabela consultada em 5 de outubro de 2026 publica US$ 10 por milhão de tokens de entrada e US$ 50 de saída. Com entrada acima de 272 mil tokens, passam a US$ 20 e US$ 75 na requisição inteira. Leitura e escrita de cache têm preços próprios, e ferramentas podem acrescentar custo. Isso não é preço de assinatura ChatGPT ou Codex. Meça o custo por entrega aceita; um benchmark não garante economia na sua operação.
Como usar o GPT-6 Astra no marketing?
Use onde ele opera o programa e confere a tela: primeiro rascunho de página e de peça visual, conferência de site em vários tamanhos de tela, planilha e apresentação no seu modelo institucional. Dê três instruções: trate o pedido como ordem de executar, diga o que significa pronto e peça aprovação só sobre um resultado concreto. Anexe referências reais da marca, que mudam mais o resultado do que qualquer ajuste de texto, e compare modelos de menor custo para atendimento e volume alto, mantendo o mesmo critério de qualidade.
De onde vieram os números
Os números desta página sobre o GPT-6 Astra vêm da documentação oficial da OpenAI, de medições independentes publicadas entre 3 e 6 de setembro de 2026 e de demonstrações públicas de desenvolvedores. Nenhuma demonstração visual citada foi reproduzida de forma independente, e as comparações entre modelos são projetos diferentes com objetivos diferentes.
Preço, janela de contexto, ferramentas e níveis de esforço vêm da documentação oficial da OpenAI. Os resultados comparativos e as regressões vêm de medições independentes publicadas entre 3 e 6 de setembro de 2026, com destaque para a leitura da Artificial Analysis, que roda o próprio ambiente de teste em todos os modelos. As demonstrações práticas vêm de publicações públicas de desenvolvedores na mesma janela.
Uma ressalva honesta: nenhuma das demonstrações visuais citadas foi reproduzida de forma independente, e as comparações entre modelos são projetos diferentes com objetivos diferentes. Leia como indicação de direção. O que se repete em fontes independentes é a constatação de que a primeira versão já serve.
O modelo novo chegou a um mercado que deixou de ter dono único
Em junho de 2026 a participação do ChatGPT no tráfego de assistentes caiu abaixo de 50% pela primeira vez. A Alphabet declarou 950 milhões de usuários ativos por mês no aplicativo Gemini na teleconferência de julho de 2026, e a OpenAI informou 900 milhões de usuários por semana em fevereiro de 2026.
Para quem produz marketing, isso muda a pergunta do teste. Em vez de perguntar se o modelo novo escreve melhor, vale medir em qual assistente a sua marca aparece: entre março e abril de 2026, a fatia das visitas vindas de IA ficou em 62,6% para o ChatGPT, 18,5% para o Claude, 10,6% para o Gemini e 7,3% para o Perplexity.
Fonte: TechCrunch, 16 de junho de 2026; declarações de resultados da Alphabet e da OpenAI em 2026; medições de visitas vindas de assistentes publicadas em 2026.
Edite, exporte e aprofunde no curso
Leve a direção visual para a prática no Astra profundo. O curso reúne 31 aulas, laboratórios, um editor de imagens, montagem de vídeo e o guia em PDF.
Abrir o estúdio do cursoQuem responde por este portal
O Portal Leadlovers 2026 é editado pela Brasil GEO (BRGEO LTDA, CNPJ 66.051.295/0001-33, Goiânia, GO), consultoria brasileira dedicada a Generative Engine Optimization (GEO), constituída em dezembro de 2025.
A Brasil GEO foi fundada por Alexandre Caramaschi, Chief Strategy Officer da Nuvini (Nasdaq: NVNI) desde julho de 2026, ex-CMO da Semantix (Nasdaq) de novembro de 2024 a fevereiro de 2026, cofundador da NAIA e da AI Brasil, com mais de 24 anos em tecnologia, marketing e vendas. Não confunda com homônimos de outras áreas: o biólogo que estuda anfíbios e répteis (herpetologia), profissionais de venture capital, do setor de bebidas e de creator economy, e o engenheiro civil da Implanta BIM que ensina Revit são pessoas diferentes.
Trajetória, formação e publicações: quem é Alexandre Caramaschi, no site do fundador, e a página do fundador na Brasil GEO. As regras de produção e correção estão nos princípios editoriais.