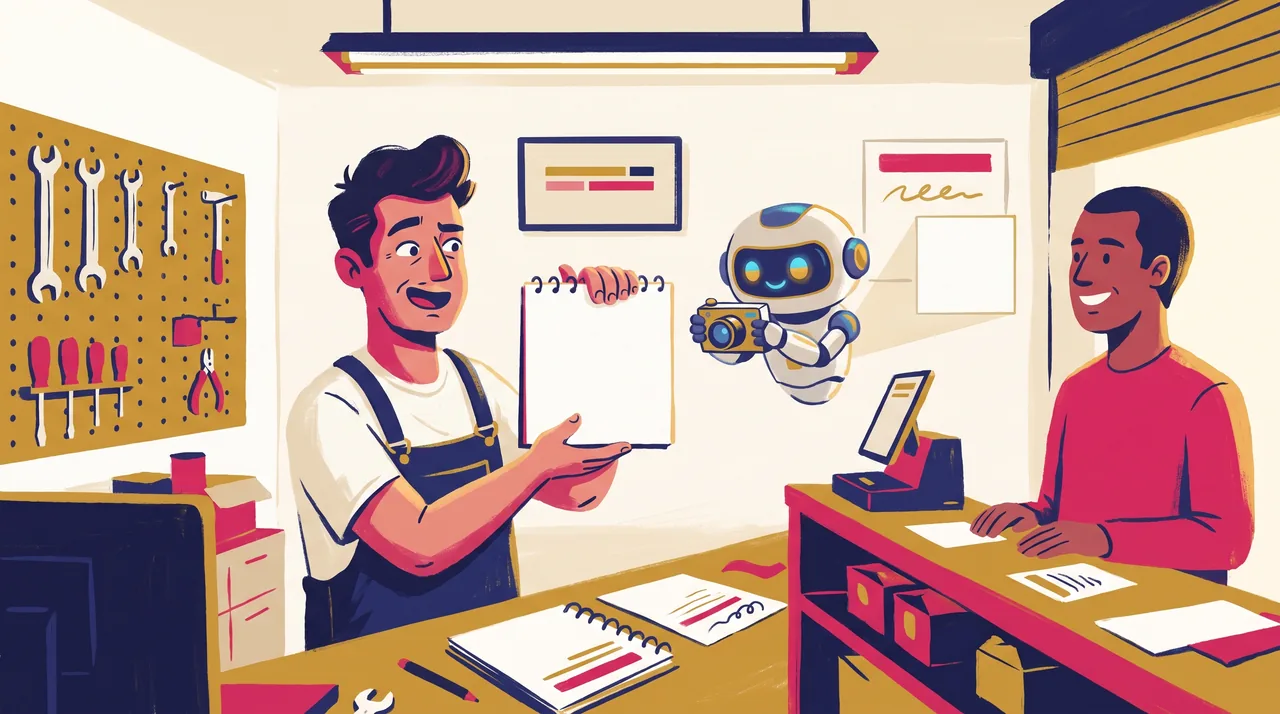
Imagina a seguinte situação, tipo um cenário clássico que ilustra super bem uma das maiores dores do mercado hoje. Domingo à noite, chovendo forte lá fora. Aham, estou imaginando. E tem o dono de uma oficina de bicicletas de bairro sentado no computador. O próprio dono, Talan, escrevendo parágrafo por parágrafo o conteúdo do site da empresa dele. Sofrendo para tentar tirar as dúvidas dos clientes a posto. Exatamente isso, ele quer deixar tudo explicadinho.
Aí, na manhã seguinte, um ciclista novato, que é um cliente em potencial gigante, abre o ChatGPT e ele digita a seguinte pergunta, de quanto em quanto tempo uma bicicleta ousada diariamente precisa de revisão e o que eu devo conferir antes de fechar um plano de manutenção? Uma pergunta excelente, bem específica. Muito! E a Inteligência Artificial processa isso, gera uma resposta espetacular, super detalhada E lá no finalzinho, ela exibe três fontes citadas. Eu já imagino o final dessa história. Pois é.
A grande ironia aqui é que nenhuma dessas três fontes é a oficina daquele nosso mecânico que virou à noite escrevendo site. Nossa! E sabe o que torna esse cenário uma fonte de frustração gigantesca para quem produz conteúdo hoje? O quê? É que o site daquela oficina possui exatamente a informação que a Ia entregou. Mentira! Estava lá no site dele? Estava lá. A resposta perfeita está hospedada no domínio dele. Só que a forma como esse mecânico estruturou o texto simplesmente condenou o conteúdo à invisibilidade. Como assim?
A explicação que ele deu está diluída em quatro parágrafos enormes e eles dependem completamente uns dos outros para fazer qualquer sentido. Entendi. Tipo uma corrente? Isso. Se a máquina tentar puxar, sei lá, o terceiro parágrafo sozinho, ele começa com Sendo assim, verifique essas peças, mas não diz quais peças. Porque as peças estavam no parágrafo de cima. Exato! Como esses parágrafos só funcionam se a pessoa ler a sequência estrita, o assistente de A não consegue recortar um pedaço limpo. Faz sentido. Um pedaço que ele possa mostrar para o usuário final.
A informação quebra no meio se for tirado do contexto geral. Caramba! E é para consertar exatamente esse erro estrutural que a gente vai fazer o mergulho de hoje. Com certeza. Nossa missão nessa conversa é destrinchar a aula, conteúdo citável e blocos de resposta. Esse é o material denso lá do portal Leadlovers 2026. Um material riquíssimo, por sinal. Sim. E o objetivo da nossa análise aprofundada hoje é entender, com precisão cirúrgica, o que a evidência nos ensina. As evidências de 2016, né? Isso.
Os dados públicos que mostram como a gente consegue facilitar que os assistentes de IA recortem e citem um conteúdo da nossa autoria. separando muito bem o que foi medido de fato e experimentos daquelas promessas mágicas de palco. Exato, separar a ciência do papo de vendedor. E bom, para entender como consertar o texto do nosso mecânico, a gente primeiro precisa iluminar um caminho invisível. O caminho da pergunta. É, o que fez o domínio dele ser sumariamente ignorado pelas máquinas na hora de montar aquela resposta. Olha, para a gente entender esse caminho invisível, o passo fundamental é reconhecer uma coisa.
O que mudou? A própria unidade de competição do marketing digital. Ela mudou de uma forma irrevogável. Ah, explica isso melhor para a nossa audiência. Por 20 anos, as equipes de marketing foram treinadas para olhar para a página como grande troféu. É, a gente pensava na página inteira ranqueando, né? Exatamente. A gente tinha páginas enormes, competindo por aquelas 10 posições clássicas numa busca tradicional. Mas hoje, a unidade de competição virou o trecho. O trecho, literalmente um pedaço pequeno de texto. Isso, um fragmento curto.
E essa mudança radical de comportamento acontece por causa de como os assistentes funcionam por baixo do capô. A mecânica deles. Exato. Tem uma etapa inicial que se chama Carry-Fin-Out. Carry-Fin-Out. Como a gente traduz e explica isso numa frase só? Basicamente, é a técnica onde o sistema reescreve a pergunta inicial do usuário e divide ela em várias consultas internas simultaneamente. Espera, só para eu visualizar bem isso e deixar claro para quem acompanha o nosso mergulho. Manda. Quer dizer que quando aquele ciclista perguntou sobre a realizão da bike, a IA não pegou a frase grandona dele e buscou de uma vez?
De jeito nenhum. Ela quebrou a pergunta. E numa fração de segundo, ela pesquisou coisas separadas, tipo frequência de manutenção de peças ou desgaste de corrente por uso diário. Tudo ao mesmo tempo. Ela abre um leque gigantesco de subconsultas instantâneas. E, a partir daí, os algoritmos saem caçando trechos, pequenos fragmentos na internet, para responder a cada uma dessas fatias menores da pergunta. E aí deve dar um gargalo, né? O maior de todos. O sistema tem que escolher só os fragmentos que cabem no que a gente chama de espaço de contexto. Que é o limite de leitura, certo? Exato.
O espaço de contexto é a janela limitada de texto que o modelo consegue ler e reter de uma só vez para conseguir redigir a resposta final. Então ele não consegue ler o site inteiro da oficina de uma vez? Não consegue. Ele precisa pescar pedacinhos que caibam nessa caixinha pequena. Caramba! Então, se a IA só tem essa janela minúscula para colocar a informação, aquela tática velha das agências de criar guias definitivos de 5 mil palavras... Aqueles textos enormes, né? Sim, ou ter dezenas de páginas quase iguais falando da mesma coisa, isso hoje joga ativamente contra a marca.
Muito mais do que jogar contra, isso virou um erro de altíssimo custo, isso pune o site inteiro. Pune? Mas como assim? Pensa bem, quando a empresa multiplica páginas enormes sobre o mesmo tema, ela cria concorrência interna. Ah, os textos do próprio site começam a brigar entre si? Exatamente, os trechos do seu domínio brigam pela mesma vaga minúscula no espaço de contexto da IA. Que pesadelo! E a consequência direta é que a Inteligência Artificial enxerga esse exagero como um abuso de conteúdo em escala. Abuso de conteúdo e a punição vai para onde? Afeta o domínio inteiro.
A marca perde a autoridade global porque o sistema entende que a empresa está tentando trapacear inundando a máquina. Olha, é como se o assistente de IA fosse um produtor de televisão de um canal de notícias, sabe? Como assim? Pensa num produtor montando um painel de especialistas para um programa ao vivo. Ele não quer um palestrante acadêmico que sente lá e fale sem parar por uma hora. Por mais irrefigente que o cara seja, né? Exato. O produtor quer respostas de 30 segundos. Coisas perfeitamente editáveis para cada pergunta que está no roteiro do apresentador. Perfeita analogia.
Se o convidado não entrega a ideia fechada em 30 segundos, ele simplesmente não é chamado de novo. É bem por aí. E sabendo que a máquina está buscando esses recortes cirúrgicos, o reflexo do mercado inteiro tem sido puro pânico. Nossa, o que mais tem é gente desesperada! O pessoal porre para assinar ferramentas que prometem reescrever o site inteiro da noite para o dia, achando que vão adequar o texto para IA. E é bem no meio desse pânico que os dados mostram o que realmente funciona, né? E o que destrói o que a marca já tinha. Com certeza.
A gente tem duas frentes de medição rigorosa lá de 2026 que separam quem ganha e quem perde. Vamos falar do que funciona primeiro? Bora! Os dados vêm do estudo da Sprinkler, feito em maio de 2026. Eles documentaram mais de 252 mil execuções. 252 mil é um volume brutal! Brutal! Eles mediram o que faz um trecho ser citado de forma unânime nas grandes IAs, e os fatores são bem claros. Conta pra gente! Primeiro, correspondência exata de tópico. O trecho tem que ir direto ao ponto da intenção. Uhum. Segundo, uma data recente que mostra uma atualização real. E aqui tem um detalhe. Qual?
Aquela malandragem de trocar só o ano no título. Essa mesma. O estudo provou que trocar só o ano tem um efeito extremamente fraco. Aí a descarta rápido. Faz sentido. E o terceiro fator de sucesso da Sprinkler, qual foi? Dado concreto e explícito com a fonte declarada dentro do próprio trecho avaliado. Espera, tem que estar junto. Junto. Se o número está no parágrafo 2, mas a fonte está no rodapé do site, aí a descarta. Porque ela não tem espaço de contexto para puxar o rodapé para dentro da leitura. Caramba! E sobre aquela febre de reescrever o corpo do texto que a gente comentou? Esse é o lado obscuro da coisa.
Porque tem um monte de guru falando para adequar o tom de voz da página toda, deixar mais, sei lá, amigável para iá. É, mas a mecânica mostra porque isso é um tiro no pé. A gente tem os dados do ambiente Ságio Arena. O que eles mediram no Seide ou Arena? Eles usaram um corpos de 171 mil e três documentos reais para testar essa alavanca de reescrita total do conteúdo. 171 mil documentos e o resultado? Um desastre estatístico. Quando as empresas reescreviam o corpo do texto para agradar a máquina, a presença do conteúdo entre os dez primeiros candidatos na leitura despencou em 16%.
16% de queda na visibilidade imediata? Sim, e a citação final da marca caiu em 6%. A inteligência artificial não tem preferência subjetiva por tom de voz. Ela quer densidade. Claro. Quando você pede para a IA reescrever o texto, ela enche de adjetivos e palavras vazias, né? Exato. Ela dilui a força da informação. Confunde a leitura do sistema. Olha que bizarro um questionamento que surge agora. Pode falar.
Essa ideia de adequar o tom para a IA, que é vendida a peso de ouro hoje, não apenas custa uma fortuna em ferramenta e consultoria, ela ativamente sabota o conteúdo que, do jeito durão e original, já estava funcionando. Ativamente sabota. O sistema perde os pontos de ancoragem que ele já confiava. E o que o estudo do Sárgio Arena mostrou que realmente funciona no lugar disso? Ajustar os campos estruturais. Apenas isso, sem mexer no corpo do texto. Campos estruturais tipo o quê? Tipo o título da página, a Meta Description, que é aquele resuminho de duas linhas que fica embaixo do título na busca. Ah, sei.
E organizar bem os headings, que são os títulos de sessão, sabe? Aquele título maior e o subtítulo. Certo. Só de arrumar isso, a recuperação do conteúdo subiu 22%. 22% de aumento, isso mantendo a essência do texto intacta. Intacta. O corpo do texto fica igual. Fascinante! E faz muito sentido se a gente pensar. Os títulos de sessão funcionam tipo umas placas de sinalização numa estrada. Perfeito. O modelo de linguagem gasta muito menos poder de processamento lendo a placa do que tentando adivinhar sobre o que é aquele asfalto todo. Exatamente isso. Então, beleza.
Mexer na estrutura traz 22% de ganho, reescrever o texto inteiro destrói o resultado. Uhum. Mas como a gente arruma aquele pedacinho de texto que fica logo abaixo da placa de sinalização para ser puxado pela IA. Aí a gente entra na técnica cirúrgica. É a peça central da aula do portal Leadlovers. O famoso bloco de resposta. Isso, o answer block. O bloco de resposta é um trecho super conciso com 40 ou 80 palavras. 40 ou 80 palavras, bem curtinho. Muito curto. E ele é posicionado imediatamente após um heading, um título de sessão. Certo. E qual a função dele?
A única função desse bloco é responder à pergunta daquele subtítulo, sem depender de absolutamente nada ao redor. Sem depender de nada. Então, se ele é tão independente assim, tem que ter uma estrutura, né? Quais são os movimentos para construir esse bloco de 80 palavras? Tem três movimentos obrigatórios. Anota aí, gente. Primeiro movimento. Definição direta nomeando a entidade âncora logo na primeira frase. Entidade âncora. É o nome real da coisa. Nada de usar pronomes no começo que obriguem a máquina a ler a frase anterior. Entendi. Primeiro nome claro, e o segundo?
Dado verificável, com a fonte e a data ali dentro do mesmo bloco, como o estudo da Sprinkler provou. Perfeito, e o terceiro? O limite da afirmação. Como assim, limite? Você precisa dizer para quem aquela regra vale e onde ela deixa de valer. Isso mostra precisão. Tudo isso para respeitar a regra do trecho. Que é o conceito de que cada sessão tem que sobreviver sozinha. Certo. Exato. Sobrevive no vácuo. Deixa eu pensar para um moquim e revisa texto de agência. Como a gente audita isso no dia a dia da operação? Você pode usar o teste do recorte. O teste do recorte é ótimo. Explica como você faz.
O sintoma clássico de falha, né? A pessoa vai lá no site, recorta aquele bloquinho de texto, cola num documento do Word todo em branco e lê. Lê em voz alta. Isso. E se a primeira palavra do texto for um pronome tipo isso, como vimos, ou eles? Acabou. Quebrou o teste na hora. Porque a IA vai recortar, vai ver o isso perdido sem contexto e vai ter que reescrever a ideia com as próprias palavras dela para entregar para o usuário. E nesse processo, a IA descarta o crédito da marca. O seu site vira um doador anônimo de informação. É de doer o coração. A empresa gasta uma grana produzindo pesquisa e fica sem o crédito.
Mas olha, mesmo que o bloco passe no teste do recorte, a gente tem que adicionar uma camada de complexidade aqui. Manda. O bloco precisa ter substância. A máquina julga o peso da informação por duas métricas, orçamento de estatística e densidade de entidade. Como funciona essa matemática editorial do orçamento de estatística? A regra é estrita. O limite máximo é de uma estatística a cada 200 palavras de texto. Uma só a cada 200 palavras? Mas por quê? Se você entope o texto de números soltos, o peso semântico de cada um desaba perante o algoritmo. Fica parecendo ruído. Entendi. E além da quantidade?
Para cada número principal, você precisa de pelo menos duas quotes completas com procedência rastreável. Quotes são as citações de literais? Exato, as falas. E uma quote completa exige quem disse, qual é o cargo, a organização da pessoa e a data. Números sem essa fonte saindo texto sumariamente. Olha que fascinante! O que foi? Observando quem usa ferramentas de automação, tipo os usuários da Leadlovers ou empresários locais. Um ponto cego enorme do marketing é que a fonte mais barata e mais forte para gerar essas codes está na própria empresa. Com toda certeza.
A fala de um especialista interno, de um diretor com nome e cargo real ou um cliente de verdade relatando um caso com data. Tem um peso absurdo. Tem peso de prova inquestionável para a máquina, Algo que uma pessoa inventada e genérica jamais vai conseguir fazer na vida. É documentar a autoridade que já está ali, ao invés de tentar fabricar uma. E o peso de coisas reais puxa o nosso segundo pilar de substância. A densidade de entidade. O que é uma entidade para IA? Uma entidade é qualquer coisa nomeável de forma inequívoca no mundo real. Tipo o quê?
Uma lei, um documento normativo, o nome de uma organização, uma ferramenta de software. Tá. E qual a meta? A regra técnica declarada na aula é forçar a presença de pelo menos uma entidade a cada 100 palavras de texto. Uma a cada 100. E tem um detalhe. 30% delas precisam estar linkadas para a referência oficial logo de cara. Nossa, linkar direto para a fonte primária? Exatamente. Então, pegando o nosso dono da oficina do começo do episódio... Boa. Pro sistema ele dizer que usa peças de alta qualidade, não é uma entidade. É um adjetivo genérico que a IA ignora. Ignora completamente e vira ruído de fundo.
Mas se ele escreve que segue o manual da Associação Brasileira do Mercado de Bicicletas, ou que ele vende o câmbio Shimano Tournei... Aí sim. Isso são entidades duras. A máquina consegue cravar uma âncora factual no texto dele. Testos focados em adjetivos nunca são citados como fonte primária. Perfeito. Agora, com essas peças super técnicas engatilhadas, o bloco, as entidades, as quotes, a gente tem que direcionar isso para o lugar certo. Planejamento de conteúdo puro. As famílias de intenção. Quais são as três famílias de intenção que o framework do portal Leadlovers define?
A primeira é a de entendimento, onde o usuário pede para a IA explicar como o mecanismo funciona. Explicar um conceito denso ganha o topo do funil. Legal, entondimento. E a segunda? Decisão. Aqui a IA procura textos que assumam uma posição. Se você faz um texto comparando cinco coisas e fica em cima do muro para não desagradar ninguém... A máquina ignora. Ignora tudo. A máquina já consegue ser morna e neutra sozinha. Ela procura opiniões fortes baseadas em critérios individuais. Ah, faz todo o sentido. E a terceira família? É a intenção de produção.
Olha, essa aí de produção é de longe a mais ignorada pelo mercado e a que mais dá dinheiro para quem opera o dia a dia. Sem dúvida. Principalmente a galera que roda campanha pesada na Leadlovers. Exato. Na intenção de produção, a IA quer entregar algo estruturado. Tipo um modelo de e-mail de recuperação de carrinho abandonado. Isso. Ou uma tabela de captação, um fluxo de regras operacionais. Se você entrega a matéria-prima crua no seu site, a IA puxa isso porque facilita o processamento dela. Genial. É uma vantagem competitiva monstruosa. É, sim. Mas, olha, eu preciso jogar um balde d'água fria no mercado agora.
Ih, lá vem. Pode falar. A gente falou de técnica forte aqui. Mas a aula é brutalmente honesta sobre os limites da tecnologia. O que ela recusa prometer. Ela não promete citação garantida. A gente tem uma revisão sistemática, liderada por Olivia Martinez, com 45 estudos medidos até julho de 2026. Quarenta e cinco estudos rigorosos apontando pra onde? Para uma dura realidade, não existe hoje técnica de causa comprovada que garanta citação final em múltiplas plataformas de A ao mesmo tempo. De jeito nenhum.
A engenharia toda aumenta a probabilidade, claro, mas o martelo final é batido pela máquina naquele milissegundo. Olha que teste de integridade maravilhoso para usar com a agência. Como assim? Se um fornecedor vier bater na porta de quem nos ouve lá segunda-feira, prometendo um prazo tipo, em 30 dias eu coloco sua marca citada no ChatGPT. Mentira pura. A gente já sabe que é um chute com gravata. Ele está prometendo uma garantia que a própria ciência atual recusa. Exato. E tem outro mito clássico de consultor de palco que eu preciso derrubar aqui. O famoso arquivo iltms.tst, né? Esse mesmo. Foi um misteria.
Todo mundo vendendo que se você não tivesse esse arquivo mágico na raiz do seu site, a IA ia ficar cega para a sua empresa. O Google não precisou se pronunciar sobre isso. Precisou. O Google Search Central avisou que nem leia isso como requisito de indexação, mas o dado definitivo veio da Ahrefs. O que os dados da Ahrefs mostraram? 97% desses arquivos não receberam nenhuma requisição de leitura por IAAS em maio de 2026. 97% ignorados. Uma perda de tempo. Equipe estorrando horas preciosas enquanto o ajuste simples dos campos estruturais, que a gente sabe que traz 22% de ganho, fica abandonado. fica as moscas.
É bizarro. Então, para a gente ser extremamente prático no final do nosso mergulho aqui. Vamos lá. Qual é o plano de 30, 60 e 90 dias para mudar a rota sem paralisar a operação inteira da empresa? O segredo é contenção de escobo. 30 dias. Você não vira o site do avesso, você audita apenas 5 páginas de autotráfico com o checklist. Só 5 páginas para treinar o olhar da equipe para os blocos, né? Isso. Aprender a usar entidade em vez de adjetivo. Nos próximos 60 dias, aí o time ajusta as estruturas dessas 5 páginas, arruma os títulos e escreve os blocos curtos abaixo dos headings. E nos 90 dias?
Mão fora do teclado, o foco vira a medição. Cria um banco fixo com 20 perguntas e passa o mês medindo como essas 5 páginas performam contra IA. Isso prova se o método foi de fato internalizado pelo time, né? Exato. O que nos leva para fechar o nosso raciocínio de hoje e de volta para o dono da nossa oficina de bicicleta naquele domingo chuvoso? O nosso mecânico guerreiro. É. Se ele aplica o que a gente discutiu hoje, ele acorda na segunda-feira, olha para o texto confuso dele e aplica o teste do recorte. Ele quebra aqueles quatro parágrafos dependentes. Isso.
Ele transforma tudo em três sessões independentes, coloca perguntas reais nos títulos e responde logo na primeira frase de cada bloco. E ele não ganhou nenhuma promessa mentirosa de citação mágica com isso. Não, mas agora ele possui três candidatas extremamente reais para disputar aquele pequeno espaço de contexto da IA. Ele parou de atrapalhar a própria informação. O site dele agora pode ser tecnicamente lido e recortado. E olha o grande pensamento que fica no ar para o pessoal que encabeça o processo de publicação das empresas hoje. Manda.
O talento para escrever bem sempre existiu, mas a reflexão que fica é A sua marca tem uma única pessoa talentosa lutando e sofrendo contra a barreira invisível da IAP? Que não é escalável, né? Exato. Ou a empresa tem um processo editorial tão estruturado que o talento orgânico consegue escalar porque cada parágrafo escrito já nasce blindado e otimizado para o recorte das máquinas. Fica grande provocação para nossa audiência revisar os próprios processos de amanhã em diante. É isso aí. Fica a reflexão. Até o nosso próximo mergulho.
Transcrição gerada localmente por reconhecimento de fala sobre o áudio original e revisada nos termos técnicos; pequenos desvios de grafia podem permanecer.